摘要:本篇是"银行业经营收益引擎"系列第 5 篇,讲反洗钱可疑交易智能甄别。银行的交易监控系统每天产生几千条告警,其中九成是误报——规则引擎"宁可错杀"的结果。人工逐条甄别,一条 15 分钟,全年几十万条,人海战术;更麻烦的是,监管处罚一年比一年重,真可疑的交易被淹没在误报里,漏报了要担责。极昆仑iInsight 做四件事:①关联图谱分析(资金流向、共用手机号/IP/设备、团伙账户),把单条告警连成网络;②非结构化融合(交易备注"代付""借款"、KYC 更新记录、账户用途说明);③可疑度排序——把真可疑的顶上来,把明显误报的降权,人工只管前面的;④STR 初稿生成 + 证据链。误报率从 90% 压到 65%(明显误报自动降权剔除,人工只处理前约 30% 高可疑告警),对应释放约 70% 甄别人工。按一年 73 万条告警、单条 15 分钟算,一年释放约 1300 万合规人力(只是举例不是承诺)。**红线:AI 只做甄别归集和 STR 初稿,不自主上报监管、不自主冻结账户。**兑现确定性标"高"——甄别效率当天可验,不依赖外部变量,效果是"处理速度和人力量"。
先破一个误区:很多人觉得反洗钱告警多是"监控系统越严格越好,宁可多报不能漏报"。真相是,规则引擎的"宁可错杀"把误报率堆到了 90% 以上,人工被淹没在误报里——真可疑的交易反而更难找,成本还更高。
还原一次可疑交易甄别的真实过程:
交易监控系统一条规则触发,生成一条告警:"某账户 3 小时内转入 50 万,随即分散转出到 5 个账户";
反洗钱专员打开这条告警,开始逐条甄别:看交易流水、查账户 KYC 背景、查历史交易记录、判断这笔钱的性质——平均一条 15 分钟;
甄别完 10 条,其中 9 条是误报:有的是个体户日常货款结算、有的是公司发工资、有的是客户自己不同账户间倒腾;
专员在 9 条误报上花了 2 个多小时,第 10 条真正可疑的,只来得及扫一眼就下班了。
这不是段子,是反洗钱一线每天的真实状态。三个问题:
1. 告警量大,人海战术。 规则引擎粗放:大额整数交易、快进快出、深夜交易,规则一触发就是几千条告警。一年下来全行几十万条,反洗钱专员逐条甄别,人力全耗在误报上。按一年 73 万条、单条 15 分钟算,处理全部告警需要近百人全年专职甄别。
2. 真可疑的被淹没。 90% 的误报意味着专员 90% 的时间在看假警报。真正可疑的交易——资金快进快出、账户间网状流转、共用手机号/设备——和误报混在一起,靠人肉在几千条里翻,漏掉是概率事件,不是偶然。
3. 监管处罚一年比一年重。 人行反洗钱罚单逐年增加,机构被罚几百万上千万的案例越来越多。漏报真可疑交易、STR 上报不及时,都是处罚理由。漏报的代价是真金白银,甄别的成本也是真金白银——两头都是钱。
一个常被忽略的真相:甄别的目的不是"减少告警",是"把真可疑的找出来"。 告警条数降不下来没关系,关键是别让专员在误报上花 90% 的时间。把真可疑的顶上来、把明显误报的降权、让人工只看前面的——这才是甄别该干的事。
顺带说一句:这个场景和场景 2(尽调自动化)一样,兑现确定性"高"——因为它的效果是处理速度和人力量,当天就能验,不依赖外部变量,不需要等效果期。
环节 | 传统方式 | 极昆仑iInsight | 差异 |
甄别对象 | 单条告警,一条一条看 | 关联图谱:单条告警连成资金网络(资金流向、共用手机号/IP/设备、团伙账户) | 从"看单条"到"看网络" |
判断依据 | 只看结构化交易流水 | 结构化交易 + 非结构化融合(交易备注"代付""借款"、KYC 更新记录、账户用途说明) | 从"看数字"到"看背景" |
处理顺序 | 按生成时间排队,误报先看 | 可疑度排序:真可疑的顶上来,明显误报的降权,人工只看前面 | 从"先来先看"到"最可疑的先看" |
甄别效率 | 单条 15 分钟,逐条人工 | 误报率 90%→65%,释放约 70% 甄别人工 | 从"人海"到"机筛人核" |
STR 上报 | 人工从零写,证据链不全 | STR 初稿自动生成 + 证据链打包,人工审核定稿 | 从"从零写"到"审核定稿" |
合规红线 | —— | AI 只做甄别归集和 STR 初稿,不自主上报监管、不自主冻结账户 | 从"没有边界"到"红线内运行" |
关键差异:传统方式是"专员在 90% 的误报里捞真可疑的";极昆仑iInsight 是"机器先筛一遍,把最可疑的排到最前面,把明显误报的剔掉,人工只管少数真可疑的"。
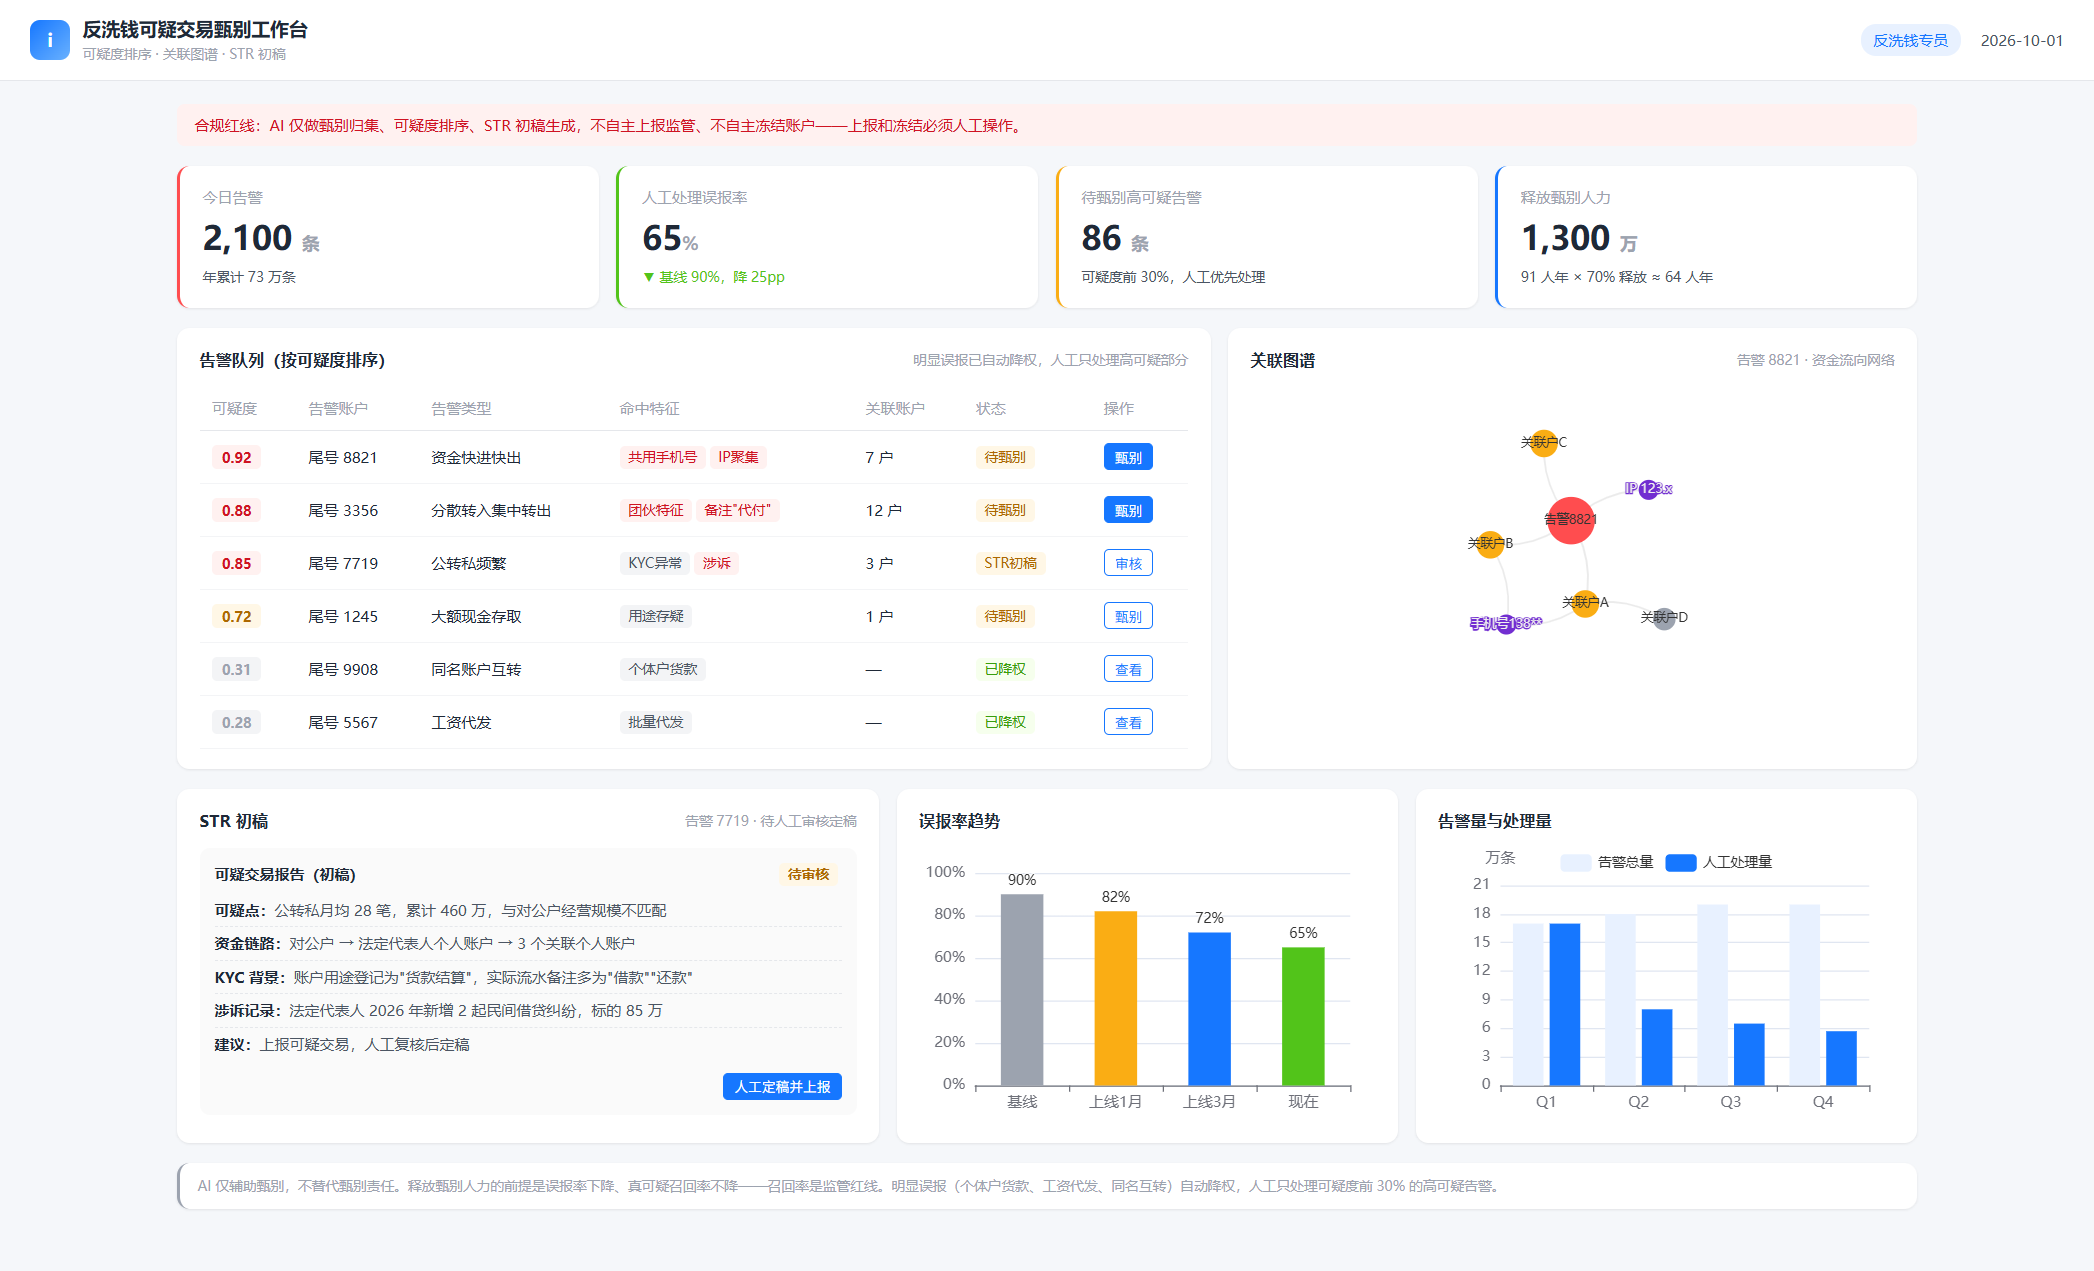
省的是误报上浪费的时间,不是甄别质量——真可疑的一条都不能漏,这是红线。
自家试算:你拿自家告警数据就能算
以下所有数字为示例口径,只是举例不是承诺。请用自家数据套公式自算。
① 基础参数(5 个数)
参数 | 含义 | 示例取值 | 数据来源 |
A | 年告警总量 | 73 万条 | 交易监控系统统计(行内真实数据) |
t | 单条人工甄别时长 | 15 分钟 | 反洗钱专员实测/工时统计 |
年工时 | 单人年有效工时 | 2000 小时(250 天 × 8 小时) | 行内口径 |
释放比例 | 可释放的甄别人工比例 | 70% | 推演值:明显误报自动降权剔除后,人工只处理前约 30% 高可疑告警,对应释放约 70% 甄别人工 |
C | 人均年全成本 | 20 万(反洗钱专员工资 + 绩效 + 社保公积金 + 办公分摊) | 行内人力成本口径 |
② 极昆仑iInsight 带来的动作变化
关联图谱分析:单条告警不再单独看——自动连出资金流向网络,识别共用手机号/IP/设备、资金快进快出链路、团伙账户群,判断"这条告警背后有没有一个更大的网络";
非结构化融合:交易备注("代付""借款""刷单")、账户 KYC 更新记录、账户用途说明、历史告警记录,全部进甄别模型——判断依据从"只看得见数字"到"看得见背景";
可疑度排序:几千条告警按可疑度从高到低排序,明显误报(个体户日常货款、工资代发、同名账户互转)自动降权,人工只处理前面的高可疑部分;
STR 初稿 + 证据链:确认为可疑交易的,自动生成 STR 初稿(可疑点、资金链路、涉及账户、KYC 背景)+ 证据链打包,反洗钱专员审核定稿后上报;
红线内运行:AI 全程只做甄别归集、排序、STR 初稿,不自主上报监管、不自主冻结账户——上报和冻结必须人工操作。
动作变化量化:明显误报(个体户货款、工资代发、同名互转)被自动降权剔除后,人工只需处理前约 30% 的高可疑告警,甄别人工释放约 70%——释放来源是"处理量从 100% 降到约 30%",不是靠降低甄别质量;人工实际处理的那部分告警,误报率从 90% 压到 65%(示例口径)。单条告警的甄别从"人工从零看"变为"机器初筛 + 人工审核高可疑部分"。
③ 经营结果(公式 + 举个例 + 因果链)
公式:
年化合规人力释放 ≈ A × t ÷ 年工时 × 释放比例 × C
其中:
A = 年告警总量
t = 单条人工甄别时长
年工时 = 单人年有效工时(250 天 × 8 小时)
释放比例 = 可释放的甄别人工比例
C = 人均年全成本
举个例(5000 亿资产城商行口径):
A = 73 万条,t = 15 分钟(0.25 小时),年工时 = 2000 小时,释放比例 = 70%,C = 20 万
73 万 × 0.25 = 18.25 万小时 ÷ 2000 小时 = 91 人年(全年处理全部告警所需人力)
91 人年 × 70% ≈ 64 人年 × 20 万 ≈ 1280 万 ≈ 1300 万
这个 1300 万是合规人力释放口径(示例口径)。等价换算:91 人年的甄别工作量,释放 70% 后约 64 人年的人工从"逐条看误报"里解放出来。它是"少花了多少甄别人力",不是"省下来的钱自动进利润"——释放的人工是转做其他合规工作,还是真减了编制,取决于行里安排。
你家用自家数代:A 是 30 万条还是 150 万条,t 是 10 分钟还是 20 分钟,释放比例 50% 还是 80%,C 是 15 万还是 30 万,自己算。A=30 万、t=10 分钟、释放 50%、C=15 万算出来约 190 万;A=150 万、t=20 分钟、释放 80%、C=30 万算出来约 6000 万——值不值立项,你比我清楚。
诚实边界(务必看):①效率提升不能以甄别质量下降为代价——误报率降了,真可疑的识别率(召回率)一条都不能降,这是监管红线,AI 是辅助甄别,不是替代甄别责任;②释放比例是推演值,取决于你家的告警结构和误报构成;③红线必须说清楚:AI 只做甄别归集、可疑度排序、STR 初稿生成,不自主上报监管、不自主冻结账户——上报和冻结是监管要求的人工动作,AI 碰都不能碰。
因果链(为什么这个数能成立):
经营场景:反洗钱可疑交易智能甄别
↓ 第一层(技术能力)
· 智能问数 + 确定性编译(甄别计算 100% 正确可追溯)
· 关联图谱(资金流向网络、共用手机号/IP/设备、团伙账户识别)
· 非结构化融合(交易备注、KYC 记录、账户用途说明)
· 行动方案生成(可疑度排序 + STR 初稿 + 证据链打包)
· 合规红线(AI 不自主上报监管、不自主冻结账户)
↓ 第二层(经营动作变化)
① 甄别对象从"单条告警一条一条看"→"关联图谱连成资金网络"
② 判断依据从"只看结构化交易流水"→"结构化 + 交易备注/KYC 非结构化融合"
③ 处理顺序从"按生成时间排队,误报先看"→"可疑度排序,真可疑的先看"
④ 甄别效率从"单条 15 分钟逐条人工"→"明显误报剔除后人工只处理前约 30% 高可疑告警,误报率 90%→65%,释放约 70% 人工"
⑤ STR 上报从"人工从零写"→"STR 初稿 + 证据链打包,人工审核定稿"
↓ 第三层(经营结果,自家数据自算)
年化合规人力释放 ≈ A × t ÷ 年工时 × 释放比例 × C
效果参考口径(示例值,非客户实际数据):
年告警总量 73 万条,单条人工甄别 15 分钟;
误报率从 90% 压到 65%(明显误报剔除,人工只处理前约 30% 高可疑告警),甄别人工释放约 70%;
全年处理全部告警约需 91 人年,释放约 64 人年,折合约 1300 万(示例口径)。
以上 73 万条、90%、65%、70%、1300 万均为示例值,不是承诺。你家的实际数取决于告警量、误报构成、反洗钱专员配置。这个场景的好处是:效率指标(处理时长、人工量)当天可验,且不碰监管红线——AI 只做甄别辅助,上报和冻结始终是人工。
这是本场景最关键的差异化。通用 ChatBI 和智能问数产品在反洗钱甄别场景里能做的,和 极昆仑iInsight 做的,差"图谱 + 非结构化 + 排序 + 证据链 + 红线"五层。
能力维度 | 通用 ChatBI / 智能问数 | 极昆仑iInsight |
查单条告警交易流水 | ✅ 能做 | ✅ 能做 |
按账户拉历史交易 | ✅ 能做 | ✅ 能做 |
出告警统计表 | ✅ 能做 | ✅ 能做 |
关联图谱(资金流向网络、共用手机号/IP/设备、团伙账户) | ❌ 做不了,只会查单表 | ✅ 单条告警连成网络,识别团伙 |
交易备注/KYC 非结构化融合 | ❌ 做不了,只查结构化 | ✅ 交易备注"代付""借款"、KYC 记录进甄别模型 |
可疑度排序(最可疑的顶上来) | ❌ 拉出全部告警让人自己翻 | ✅ 几千条排序,人工只看前面 |
STR 初稿 + 证据链打包 | ❌ 给不出 | ✅ 自动生成 STR 初稿 + 证据链,人工审核定稿 |
合规红线治理(不自主上报、不冻结) | ❌ 没有这层设计 | ✅ 红线内置,上报/冻结必须人工 |
壁垒拆解:
壁垒 1:关联图谱,ChatBI 只会查单表 反洗钱的关键是"看网络,不是看单条"。一条 50 万快进快出的告警,单看像个误报(个体户日常结算),连上图谱一看——这个账户和另外 5 个账户共用手机号、资金 3 小时走了一圈回到起点——那就是团伙洗钱的典型链路。通用 ChatBI 只能按账户查表,做不了跨账户的资金网络分析,识别不了团伙,这是甄别和"查数据"的分水岭。
壁垒 2:判断依据要非结构化,ChatBI 只看得见数字 交易备注里"代付""借款""刷单"、KYC 更新记录里账户用途的描述、历史告警的处理结论——这些文本信息是判断一笔交易可不可疑的重要依据。通用 ChatBI 查不出文本语义,判断依据就只剩金额和频次,甄别准确率上不去,误报就压不下来。
壁垒 3:要的是"排序",不是"全部拉出来" 几千条告警,ChatBI 能全部拉给你,然后呢?专员还是得从头翻。极昆仑iInsight 做的是可疑度排序——把最可疑的顶到最前面,把明显误报的降权,人工的时间花在刀刃上。"拉数据"和"排序后让人只看重点"是两件事,后者才是效率的来源。
壁垒 4:STR 初稿 + 证据链,监管要的是一份能交的报告 确认为可疑交易后要上报 STR,监管要的是一份完整报告:可疑点、资金链路、涉及账户、KYC 背景、判断依据,还得有证据链。通用 ChatBI 给不出"报告 + 证据链",只能给数据片段。极昆仑iInsight 自动生成 STR 初稿 + 证据链打包,专员审核定稿——把"从零写报告"变成"审核初稿"。
壁垒 5:红线治理,这是银行敢用的前提 反洗钱是强监管场景,AI 能不能"碰"上报和冻结,是行里敢不敢用的前提。极昆仑iInsight 把红线做进设计里:AI 只做甄别归集、排序、STR 初稿,不自主上报监管、不自主冻结账户——上报和冻结永远是人工动作。通用 ChatBI 没有这层治理设计,在强监管场景里,没有红线的工具行里不敢用。
一句话:通用 ChatBI 解决"查得到流水、拉得出告警",极昆仑iInsight 解决"图谱连成网络、非结构化融进判断、可疑度排序、STR 初稿 + 证据链、红线内置"——而反洗钱甄别要的是把真可疑的找出来 + 合规红线内运行,不是一张告警清单。
这个场景的甄别效率当天就能验——兑现确定性"高",因为效果是处理速度和人力量,不依赖外部变量,不需要等效果期。
如果你家反洗钱团队也陷在"日均几千条告警、九成误报、专员逐条看、真可疑的被淹没"里,可预约一次 30 分钟需求对齐(不带销售,只看场景适配度——你家告警量级、交易备注/KYC 文本质量、反洗钱系统能不能对接)。
需要的话可以进一步做 概念验证:拿你家历史告警数据(含已定性结论的告警)跑一遍 AI 甄别,对比三件事:①误报剔除率——AI 判断为误报的,人工复核后是不是真误报;②真可疑识别率——历史已上报的 STR,AI 能不能识别出来(召回率不能降);③单条处理时长——AI 排序 + 初筛后,人工处理一条的时间对比。
验证什么、不验证什么,先说清楚:
概念验证验证的是误报剔除率、真可疑识别率(召回率)、单条处理时长——这些用历史告警数据当天能核,不需要等效果期;
概念验证不改变监管责任——AI 只是甄别辅助,STR 上报、账户冻结永远是反洗钱专员的人工动作,这是红线,POC 阶段就按红线跑;
涉及客户交易数据的 POC 走数据安全路径(行内脱敏环境),合规流程先过。
想试?拿你家一个月的告警数据(含已定性结论),我们跑一遍"AI 排序 + 初筛 + STR 初稿"给你看。误报剔得掉多少、真可疑的漏没漏、一条省多少时间,当场判断——红线也当场演示:上报和冻结,AI 碰都不碰。