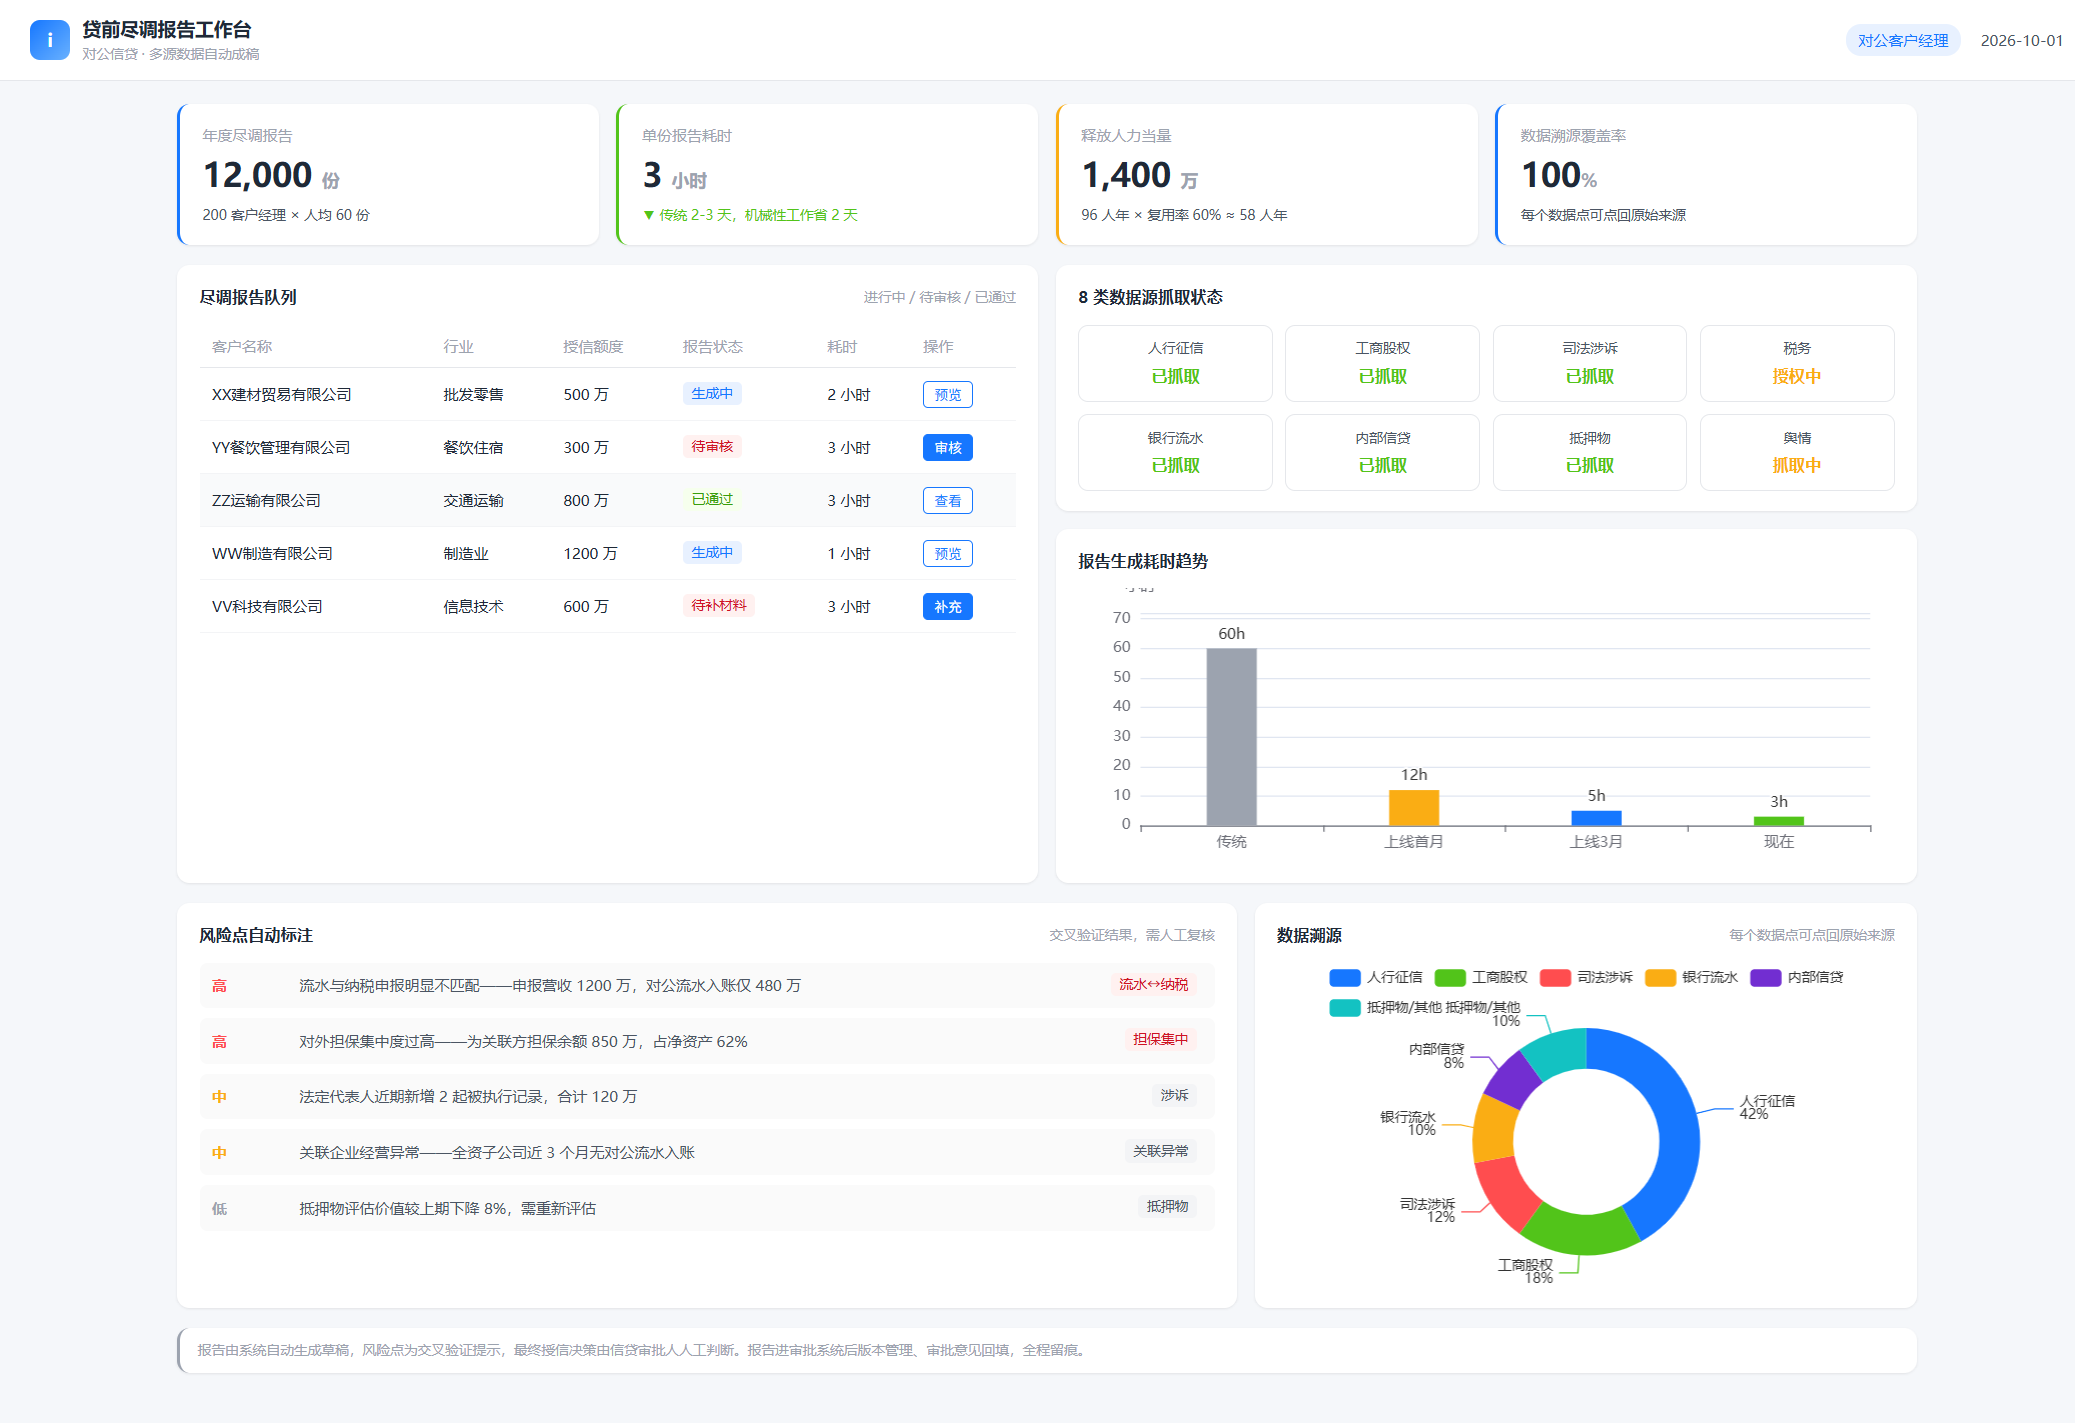
摘要:本篇讲 10 大场景里兑现确定性最高的一个——贷前尽调报告自动生成。为什么确定性最高?因为这个场景当天就能验,现场计时即可,不依赖任何外部变量。一份尽调报告传统要写 2-3 天,但其中一大半时间不是在"调查",而是在复制粘贴:通过行内征信系统打征信报告、上司法网查涉诉、拉流水做 Excel、把数据填进模板、调格式改字号。极昆仑iInsight 做四件事:①多源数据自动抓取(人行征信、工商、司法、税务、流水、内部信贷,每个数据点带出处);②按行内模板一键成稿,2-3 天→约 3 小时;③交叉验证自动标注风险点(流水与纳税不匹配、对外担保集中、涉诉);④数据溯源,贷审会审、审计查,每个数都能点回原始来源。收益按"年尽调份数 × 每份节省天数"折算人力当量:示例按对公客户经理 200 人、人均年 60 份、每份省 2 天算,一年释放约 1400 万人力当量(只是举例不是承诺)。这是工时释放口径,不是增量收入口径,省下的时间能不能变成价值,取决于客户经理是否拿去做管户和营销。
先破一个误区:很多人以为尽调写得慢,是因为客户经理"认真负责、看得细"。真相是,2-3 天里真正在做判断的时间可能只有半天,剩下两天是机械劳动。
还原一份对公/小微尽调报告的真实生产过程:
查数据:通过行内信贷系统发起人行征信查询(企业征信需客户授权),上企查查/工商查股权穿透,上裁判文书网和执行信息网查涉诉,找客户要纳税证明、银行流水、购销合同,从内部信贷系统拉历史授信和还款记录——登录五六个系统,把数据一份份下载下来
搬数据:把征信 PDF、流水 Excel、工商截图里的数据,手工搬进尽调报告模板——公司概况、股权结构、财务指标、担保情况,复制粘贴 + 调格式;
核数据:流水和纳税申报对得上吗?合同和发票对得上吗?对外担保有没有集中的风险?——这一步靠客户经理经验,漏看是常态;
写结论:风险点、授信建议、担保方案——真正花脑子的部分。
数据来源至少有 8 类:人行征信、工商股权、司法涉诉(裁判文书/执行信息)、税务(客户授权提供/税银接口)、银行流水、内部信贷历史、抵押物权证、舆情。每一类都要登录系统、下载、搬运、贴进模板。 这就是"一份 2-3 天"的真相。
三个问题:
1. 客户经理的时间被报告吃掉。 对公客户经理一年要做约 60 份尽调,一份 2-3 天,意味着一年近半年的工作日耗在写报告上。这时间本来该花在管户、拓客、维护客户关系上——那是能带来存款和收入的时间。写报告不创造收入,是纯成本。
2. 报告质量靠个人,口径不统一。 复制粘贴最容易错行、错列——征信报告某一行搬错,审批人根本看不出来;十个客户经理写十个风格的报告,风险点有的写三行、有的写三页。质量方差极大,且不可控。
3. 审批和审计不信任报告。 因为报告是人工搬运的,审批人收到报告第一件事不是看结论,是重新核数——等于报告白写一遍;审计查报告要数据出处,客户经理得翻出原始下载件证明"这个数不是编的"。人工搬运的产物,天然不被信任,核数成本反而比写报告还高。
特别提一下小微客户经理:户数多(一个人管几百户)、单户金额小、模板一模一样——机械劳动比例最高,最苦,也最值得救。
环节 | 传统方式 | 极昆仑iInsight | 差异 |
数据收集 | 登录 5-6 个系统人工抓取,一份约 2 天 | 多源自动抓取:人行征信、工商、司法、税务、流水、内部信贷,分钟级完成,每个数据点带出处 | 从"人工搬运"到"自动聚合" |
报告撰写 | 模板手工填充,复制粘贴 + 调格式 | 按行内模板一键成稿(Word,可直接进审批系统),客户经理只补现场调查、面谈、抵押评估 | 从"写报告"到"补报告" |
风险点识别 | 靠客户经理经验,漏写是常态 | 交叉验证自动标注:流水与纳税不匹配、对外担保集中、涉诉记录、关联企业风险 | 从"靠经验"到"系统兜底" |
数据可信度 | 审批人收到报告先重新核数 | 每个数据点可点回原始来源,贷审会/审计直接核对 | 从"重新核一遍"到"点开即验" |
交付时长 | 一份 2-3 天 | 一份约 3 小时(数据抓取 + 草稿生成 + 人工补充) | 从"天"到"小时" |
版本与审批 | 报告散在个人电脑,改版难追 | 报告进审批系统,版本管理、审批意见回填 | 从"散落"到"闭环" |
关键差异:传统方式是"客户经理花 2 天做信息搬运 + 半天做判断";极昆仑iInsight 是"机器花 10 分钟做信息聚合 + 客户经理花 3 小时做判断和补充"。AI 替代的是搬运,不是判断——现场调查、面谈、抵押物评估、最终授信建议,永远留给客户经理。这也是"数据可溯源"为什么必须做:AI 生成的东西如果没有出处,贷审会不敢用,审计过不了。
自家试算:你拿自家尽调业务量就能算
以下所有数字为示例口径,只是举例不是承诺。请用自家数据套公式自算。
① 基础参数(4 个数)
参数 | 含义 | 示例取值 | 数据来源 |
N | 全年尽调报告份数 | 12000 份(200 客户经理 × 人均 60 份) | 信贷系统按客户经理统计 |
t | 每份节省天数(机械性工作) | 2 天(传统 2-3 天,其中现场调查/判断约 0.5 天,AI 替代不了) | 现场计时实测 |
复用率 | 释放时间有效复用比例 | 0.6 | 碎片化时间不可能 100% 复用,取保守值 |
C | 人均年全成本 | 24 万(工资 + 绩效 + 社保公积金 + 办公分摊) | 行内人力成本口径 |
② 极昆仑iInsight 带来的动作变化
多源数据自动抓取:人行征信、工商股权、司法涉诉、税务(客户授权提供或税银接口)、银行流水、内部信贷历史、抵押物、舆情,全部自动拉取、自动解析(征信 PDF、流水 Excel、司法网页都能解析)、自动结构化入库;
一键成稿:按行内尽调模板自动生成报告草稿(Word 格式,直接进审批系统),公司概况、股权结构、财务指标、担保情况全部填好,客户经理只补现场调查、面谈记录、抵押物评估;
风险点自动标注:交叉验证自动提示——流水与纳税申报明显不匹配、对外担保集中度过高、有涉诉记录、关联企业异常,生成风险点清单附在报告里;
数据溯源:报告里每个数据点都能点回原始来源(哪份征信、哪笔流水、哪个判决文书),贷审会和审计直接核对,不用重新翻原始件;
版本与审批:报告进审批系统,版本管理,审批意见回填,客户经理按意见补充,全程留痕。
动作变化量化:每份尽调报告的生产时间,从 2-3 天压到约 3 小时(示例口径);其中机械性工作(数据抓取 + 模板填充 + 格式)约省 2 天。
③ 经营结果(公式 + 举个例 + 因果链)
公式:
年化人力当量释放 ≈ N × t ÷ 250(工作日)× 复用率 × C(人均年全成本)
其中:
N = 全年尽调报告份数
t = 每份节省天数(只算机械性工作,不算现场调查)
250 = 年工作日
复用率 = 释放时间的有效复用比例
C = 人均年全成本
举个例(5000 亿资产城商行口径):
N = 12000 份(200 人 × 60 份),t = 2 天,复用率 = 0.6,C = 24 万
12000 × 2 ÷ 250 × 0.6 × 24 万 ≈ 1380 万 ≈ 1400 万
这个 1400 万是人力当量释放口径(示例口径),不是增量收入。等价换算:12000 份 × 2 天 = 24000 人天/年 ≈ 96 人年,按复用率 60% 折算约 58 人年的产能回到客户经理手上。它是"少干了多少活",不是"多赚了多少钱"——别拿 1400 万当"多赚的钱"对外讲,那是口径错误。
你家用自家数代:N 是 6000 份还是 24000 份,t 是 1.5 天还是 2.5 天,复用率 0.5 还是 0.8,C 是 18 万还是 35 万,自己算。N=6000、t=1.5、复用率 0.5、C=18 万算出来约 320 万;N=24000、t=2.5、复用率 0.8、C=35 万算出来约 6700 万——值不值立项,你比我清楚。
诚实边界(务必看):这是效率/成本节约口径,兑现确定性标"高",和场景 1(违约预警)标"中"不同——这个场景当天就能验,不需要等 30-60 天看效果,也不依赖任何外部变量。但要说清楚两件事:①省下的是"机械劳动时间",不是"客户经理这个人"——AI 不会让客户经理失业,报告里 0.5 天的现场调查和判断还是人干;②省下的时间能不能变成存款和收入,取决于客户经理是否拿去做管户和营销——这是管理动作,不是 AI 能保证的。我们只说"省了多少时间",不说"多赚了多少钱"。
因果链(为什么这个数能成立):
经营场景:贷前尽调报告自动生成
↓ 第一层(技术能力)
· 智能问数 + 确定性编译(数据抓取、交叉验证计算 100% 正确可追溯)
· 多源数据解析(人行征信 PDF、司法网页、流水 Excel 都能解析)
· 文档生成(按行内模板一键成稿,不是出表格,是出 Word 报告)
· 数据溯源(每个数据点可点回原始来源,AI 幻觉的出口)
· 工作流对接(报告进审批系统,版本管理、审批意见回填)
↓ 第二层(经营动作变化)
① 数据收集从"登录 5-6 个系统人工抓取(约 2 天)"→"多源自动抓取(分钟级)"
② 报告撰写从"模板手工填充复制粘贴"→"按行内模板一键成稿,只补现场调查"
③ 风险点识别从"靠客户经理经验漏写是常态"→"交叉验证自动标注 + 风险点清单"
④ 数据可信度从"审批人重新核数"→"每个数据点可点回原始来源"
⑤ 交付时长从"一份 2-3 天"→"一份约 3 小时"
⑥ 审批流转从"报告散在个人电脑"→"进审批系统,版本管理、意见回填"
↓ 第三层(经营结果,自家数据自算)
年化人力当量释放 ≈ N × t ÷ 250 × 复用率 × C
效果参考口径(示例值,非客户实际数据):
对公客户经理 200 人,人均年尽调 60 份,合计 12000 份;
每份传统 2-3 天,机械性工作约 2 天(AI 替代部分),现场调查/判断约 0.5 天(人干部分);
年释放 24000 人天 ≈ 96 人年,按复用率 60% 折算约 58 人年产能回到客户经理手上,折合约 1400 万(示例口径)。
以上 200 人、60 份、2 天、96 人年、1400 万均为示例值,不是承诺。你家的实际数取决于尽调业务量、模板标准化程度、审批系统的对接深度。这个场景的好处是:每个数都能现场计时验证,不需要你信任何归因模型。
这是本场景最关键的差异化。通用 ChatBI 和智能问数产品在尽调报告场景里能做的,和 极昆仑iInsight 做的,差"文档 + 溯源 + 工作流"三层。
能力维度 | 通用 ChatBI / 智能问数 | 极昆仑iInsight |
查自家行内数据 | ✅ 能做(连了就能查) | ✅ 能做 |
拉流水分析表 | ✅ 能做 | ✅ 能做 |
人行征信 PDF 解析 | ❌ 接不了人行接口,解析不了 PDF | ✅ 自动拉取 + 解析征信报告 |
工商/司法网页数据抓取 | ❌ 只能查已接入的数据源 | ✅ 工商股权穿透、司法涉诉自动抓取 |
按行内模板生成 Word 尽调报告 | ❌ 只会出表格,出不了文档 | ✅ 一键成稿,直接进审批系统 |
数据溯源(每个数点回原始来源) | ❌ 给不出证据链 | ✅ 每个数据点可点回原始凭证 |
风险点自动标注(交叉验证) | ❌ 只给数据不给判断 | ✅ 流水与纳税不匹配、担保集中、涉诉自动提示 |
审批系统对接(版本/意见回填) | ❌ 没有工作流能力 | ✅ 报告进审批,版本管理,意见回填 |
壁垒拆解:
壁垒 1:外部数据接入 + 解析,ChatBI 查不了也解析不了 尽调的数据源一半在行外:人行征信是 PDF 报告、司法是网页、工商是接口。通用 ChatBI 只能查"已经连进数据库的结构化表",人行征信 PDF、司法网页这些它既接不进来、也解析不了。尽调报告恰恰最缺的是行外数据——没有征信、没有涉诉、没有工商穿透,报告就是"半个报告"。能不能把行外数据自动拉进来、解析出来、结构化入库,是这道壁垒的第一关。
壁垒 2:要的是文档,不是表格 尽调报告的交付物是文档——按行内模板、带结论建议、能进审批系统的 Word 报告。通用 ChatBI 的交付物是表格——查个数据、拉个表可以,生成一份"公司概况 + 财务分析 + 风险点 + 授信建议"的完整报告,它做不到。尽调场景要的是"成稿",不是"出表",这决定了 ChatBI 连入口都不在。
壁垒 3:数据溯源,AI 幻觉的出口 这是最硬的一条。AI 生成的报告,审批人凭什么信?贷审会凭什么过?审计凭什么不查?答案只有一个:每个数据点都能点回原始来源——"这个数来自哪份征信报告、哪笔流水、哪个判决文书"。通用 ChatBI 给不出证据链(大模型生成的内容天然不可溯源);极昆仑iInsight 的每个数据点带出处,这是确定性编译 + 溯源的能力。没有溯源,AI 报告在银行永远只是"草稿";有溯源,AI 报告才敢进审批系统。
壁垒 4:审批工作流,报告要能"跑起来" 报告生成不是终点,进审批系统、版本管理、审批意见回填才是闭环。通用 ChatBI 没有工作流能力,生成完就结束了;极昆仑iInsight 的 work_order 表承载报告提交 → 审批 → 意见回填 → 版本迭代全链路。报告生成 + 审批流转是一个整体,拆开做,客户经理还是要在两个系统间搬运。
一句话:通用 ChatBI 解决"查得动、出表快",极昆仑iInsight 解决"行外数据拉得进、文档成得了稿、数据点溯得到源、报告进得了审批系统"——而尽调报告要的是完整交付物 + 可审计证据链 + 审批闭环,不是一张表。
这个场景当天就能验,现场计时即可——不需要等 30-60 天看效果,不需要你信任何归因模型。
如果你家对公/小微客户经理也陷在"一份尽调 2-3 天、一大半时间在复制粘贴、审批人拿到报告先重新核数"里,可预约一次 30 分钟需求对齐(不带销售,只看场景适配度——你家尽调模板标准化程度、行外数据源有没有授权接口、审批系统能不能对接)。
需要的话可以进一步做 现场概念验证:拿客户经理手头一份真实尽调案例,现场对比"传统方式写一份 vs 极昆仑iInsight 生成一份",计时 + 核对数据点覆盖率。
验证什么、不验证什么,先说清楚:
概念验证验证的是数据抓取覆盖率(人行征信/工商/司法/流水数据点全不全)、溯源准确性(每个数能否点回原始来源)、模板匹配度(生成的报告符不符合行内模板)、风险点标注合理性——这些当场能核,不需要等效果期;
概念验证不承诺"客户经理能多创造多少收入"——那是管理动作,取决于释放的时间是否投入管户和营销,不是 AI 单方面能保证的。我们只承诺"省了多少时间、数据点是否可溯源",这两个当场可验;
涉及行外数据的 POC 要过数据授权路径(人行征信走合法授权、司法/工商走公开接口),POC 阶段也可以先用脱敏/样例数据演示全流程,再用真实数据验证。
想试?现场计时:拿你手头一份尽调,传统方式写一遍 vs 极昆仑iInsight 生成一遍,看时间差、看数据点覆盖率、看风险点标得准不准。数据抓取全不全、溯源点不点得开、模板贴不贴得上,当场判断——这个场景不需要等,试了就知道。